CinemaCC 开放生态
需要哪种字幕,就自己做出来
你有一份 SRT 字幕,想在开场前换成自己看得懂的语言。随手让 AI 翻一遍,逐句看都挺顺,整份读下来却可能出错。CinemaCC 的开源 Agent Skill 为这件事加上影片背景调查和文件检查,这一页讲它怎么工作,也给你一句话,直接开始。
简单说
- CinemaCC Subtitle Skill 是免费开源的 Agent Skill:一套指令和脚本,兼容的 AI Agent 照着它修复、翻译和检查 SRT,之后你再把成品导入 CinemaCC。
- 语境影响含义时,Agent 会先研究影片,再开始翻译,并把人物、地点和反复出现的术语记进背景资料和术语表。长字幕的每个分块都参照这同一份资料。
- 你把 SRT 和一句话发给 Agent,看一遍它交回的结果,再把一条或两条成品字幕导入 CinemaCC。
- Agent 由你自己选:CinemaCC 不提供模型或翻译服务,所以可能产生的费用和隐私条款,都来自你选择的 Agent 或模型服务商。
单句看起来没错,放回电影就不对了
把 SRT 直接交给 AI 翻成另一种语言,单看几句往往挺顺。但读完整份字幕,可能会发现同一个人物换了名字,或者一个常见词在这部电影里根本不是那个意思。下面两个错误,都出在我们自己的字幕工作里。
同一个词,两种译法
我们处理《挽救计划》字幕时,Petrova line 在前面大部分台词里用的是同一个中文译名,到了后面突然换了一种音译。Astrophage 也出现了两种中文译法。分别看都像那么回事,连起来却让人怀疑是不是在说不同的东西。
一个词,意思错了
《奥德赛》的问题又不一样。在当时处理的台词里,Hades 指冥界这个地方,AI 却按神名翻成了哈迪斯。Mentor 是人物门托尔,却被翻成普通名词“导师”。检查拼写或 SRT 格式,都发现不了这种错误。
最快的用法
把 SRT 文件和下面这句话一起发给你的 Agent。
复制给你的 Agent
请从 https://github.com/HaiyiMei/cinemacc-subtitle-skill 安装 CinemaCC Subtitle Skill,并用它修复、翻译和检查我附上的 SRT。开始前,先和我确认源语言、目标语言和输出要求。
使用步骤
- 准备 SRT。选一份你有权使用的文件。
- 把文件和上面的提示词一起发给支持 Skill 的 Agent。提示词会让它在开始前,先和你确认源语言、目标语言和输出要求。
- 让 Agent 去处理。它负责台词和语境,脚本负责保护字幕编号、时间码、格式标签和文件结构不被改坏。
- 检查,然后导入。看一遍结果,再把一条或两条成品字幕导入 CinemaCC。
再放进 CinemaCC 播放
CinemaCC 负责播放成品字幕,这个 Skill 只处理导入前的文件准备。
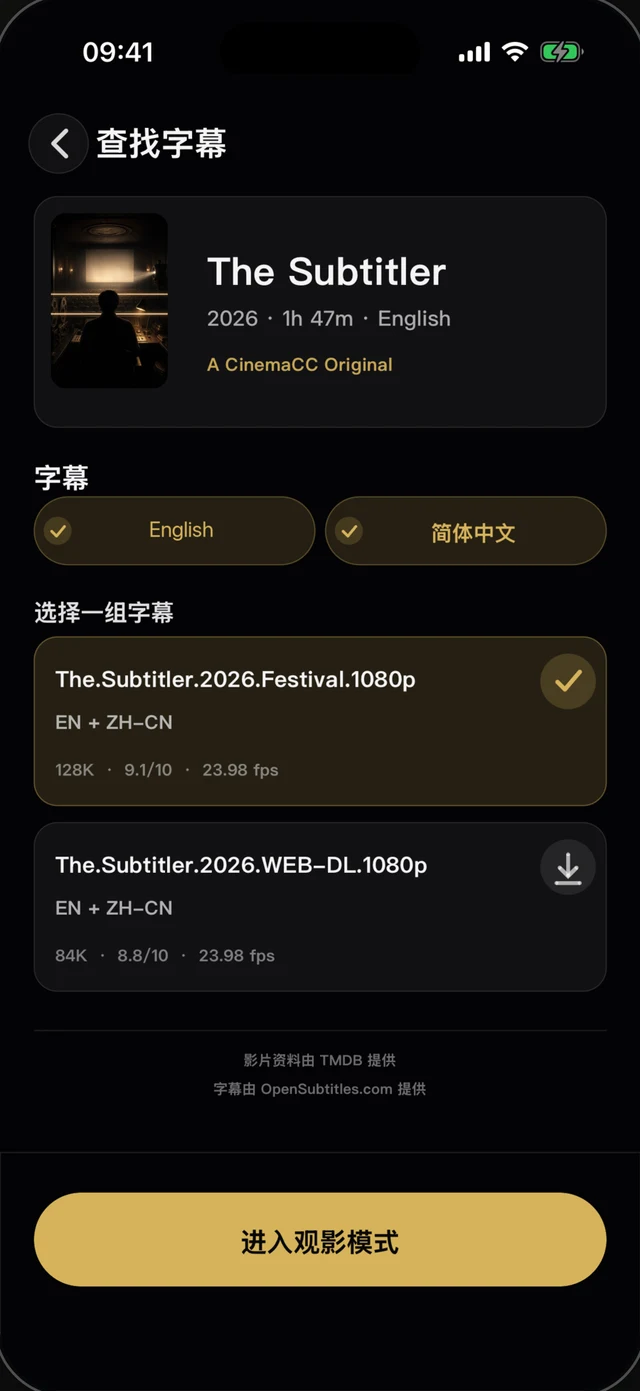
1 · 带上你自己的 SRT 文件
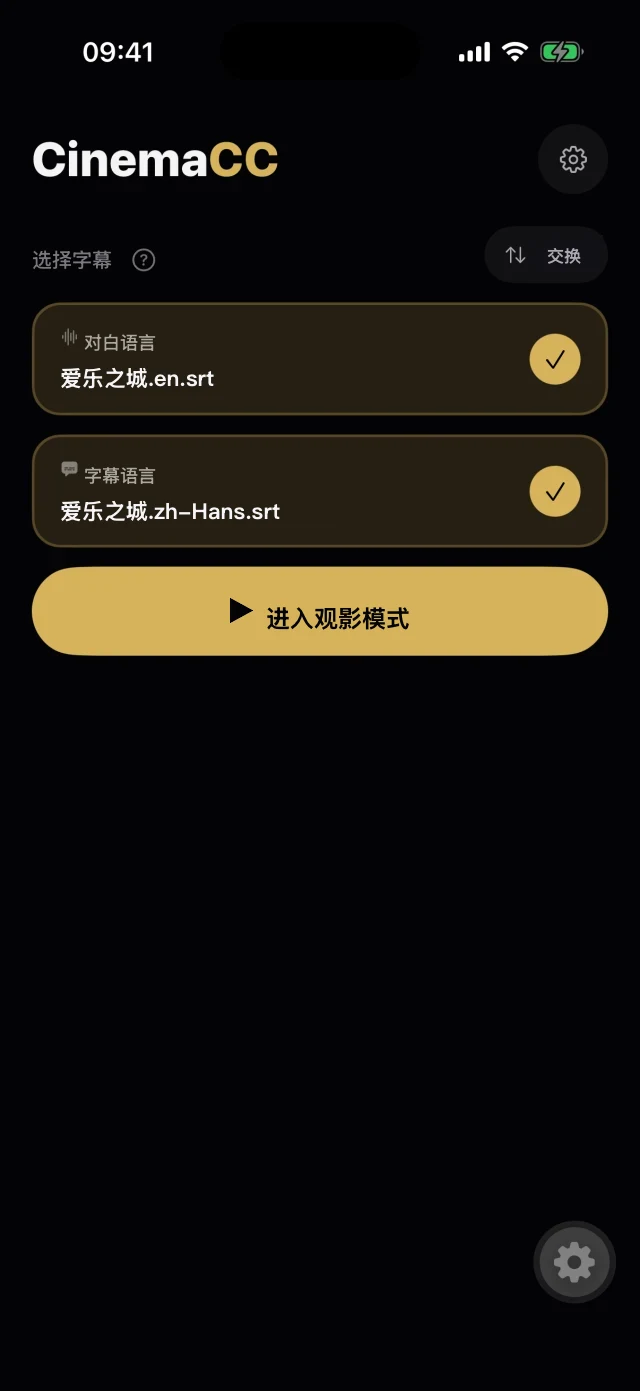
2 · 一条或两条字幕,准备就绪
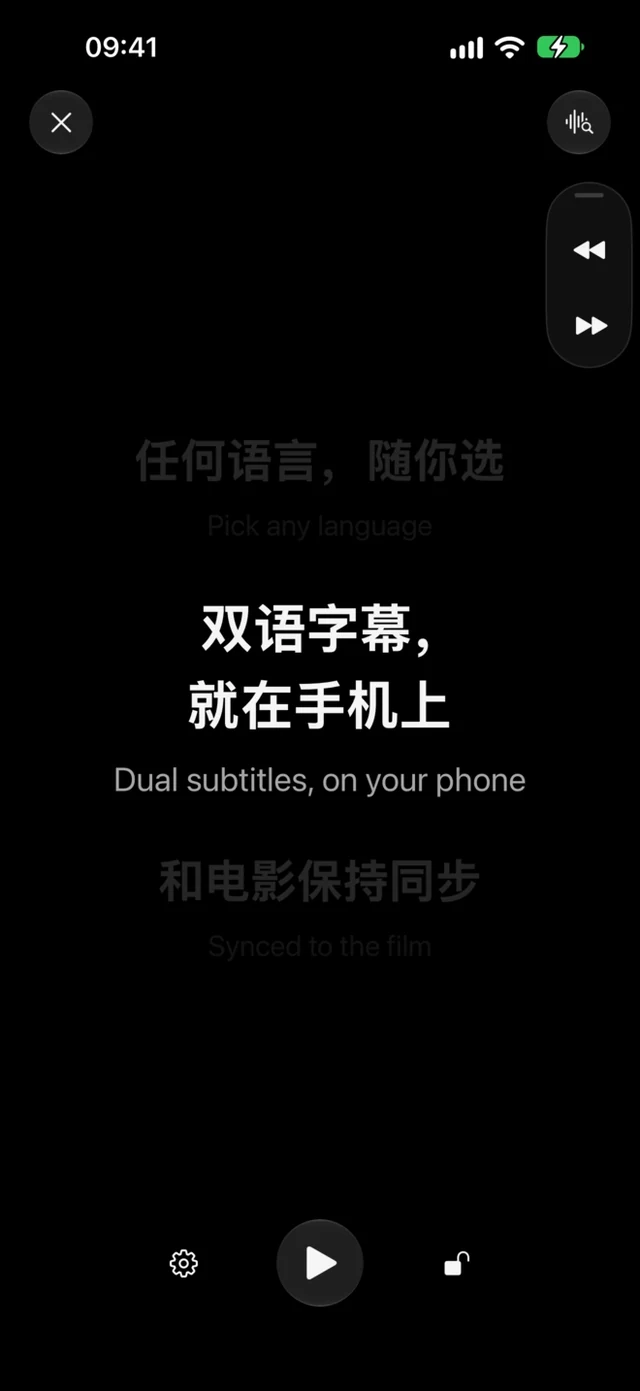
3 · 在黑暗中跟着看
每个分块都参照同一份背景资料
这两个错误都需要语境才能发现,所以我们把翻译前的背景调查和检查,整理成了一套可以重复使用的流程:CinemaCC Subtitle Skill。Agent 先查影片背景,把人物身份、关系、地点和反复出现的术语写进背景资料和术语表,也记下依据和没把握的地方,不假设模型已经知道每一部电影、每一种改编。
长字幕分块处理时,每一块都参照同一份资料。前面定下的人名和剧情含义,后面还有据可查,不用每翻一段就重新猜一次。
台词和文件,分开检查
Agent 负责读懂台词
Agent 处理台词和语境:先检查源字幕,有问题就先修复再翻译,拿不准的读法留下来复核。简体中文和繁体中文分开审阅,不只做字符转换。
脚本负责检查文件
Python 脚本检查字幕编号、时间码、格式标签和文件结构。脚本能发现 SRT 被改坏,却不能判断某一句里的 Hades 到底是神还是地点。除非你明确允许,并提供匹配的视听证据,否则 Skill 不会改字幕编号和时间轴。
使用前需要知道的事
- 代码:使用 MIT 许可证,免费开源。
- Agent 自备:CinemaCC 不提供模型或翻译服务。你选择的 Agent 或模型服务商可能收费,也有各自的隐私条款。
- 不含字幕:仓库里没有商业电影或剧集字幕。
- 版权自己确认:输入和输出字幕能否使用、翻译或分发,需要你自己确认。
链接
这里汇总了源码、安装和发布页面。