CinemaCC 開放生態
需要哪種字幕,就自己做出來
你有一份 SRT 字幕檔,想在開場前換成自己看得懂的語言。隨手讓 AI 翻一遍,逐句看起來都很順,整份讀下來卻可能出錯。CinemaCC 的開源 Agent Skill 為這件事加上電影背景調查和檔案檢查,這一頁說明它怎麼運作,也給你一句話,直接開始。
簡單說
- CinemaCC Subtitle Skill 是免費開源的 Agent Skill:一套指令和腳本,相容的 AI Agent 照著它修復、翻譯和檢查 SRT,之後你再把完成的字幕匯入 CinemaCC。
- 語境影響含義時,Agent 會先研究電影,再開始翻譯,並把角色、地點和反覆出現的術語記進背景資料和術語表。長字幕的每個分段都參照這同一份資料。
- 你把 SRT 和一句話傳給 Agent,看一遍它交回的結果,再把一條或兩條完成的字幕匯入 CinemaCC。
- Agent 由你自己選:CinemaCC 不提供模型或翻譯服務,所以可能產生的費用和隱私條款,都來自你選擇的 Agent 或模型服務商。
單句看起來沒錯,放回電影就不對了
把 SRT 直接交給 AI 翻成另一種語言,單看幾句往往很順。但讀完整份字幕,可能會發現同一個角色換了名字,或是一個常見詞在這部電影裡根本不是那個意思。下面兩個錯誤,都出在我們自己的字幕工作裡。
同一個詞,兩種譯法
我們處理 Project Hail Mary 字幕時,Petrova line 在前面大部分台詞裡用的是同一個中文譯名,到了後面突然換了一種音譯。Astrophage 也出現了兩種中文譯法。分開看都說得通,連起來卻讓人懷疑是不是在說不同的東西。
一個詞,意思錯了
《奧德賽》的問題又不一樣。在當時處理的台詞裡,Hades 指冥界這個地方,AI 卻當成神名來翻。Mentor 是角色的名字,卻被翻成一般名詞「導師」。檢查拼字或 SRT 格式,都找不出這種錯誤。
最快的用法
把 SRT 檔案和下面這句話一起傳給你的 Agent。
複製給你的 Agent
請從 https://github.com/HaiyiMei/cinemacc-subtitle-skill 安裝 CinemaCC Subtitle Skill,並用它修復、翻譯和檢查我附上的 SRT。開始前,先和我確認來源語言、目標語言和輸出要求。
使用步驟
- 準備 SRT。選一份你有權使用的檔案。
- 把檔案和上面的提示詞一起傳給支援 Skill 的 Agent。提示詞會讓它在開始前,先和你確認來源語言、目標語言和輸出要求。
- 讓 Agent 去處理。它負責台詞和語境,腳本負責保護字幕編號、時間碼、格式標籤和檔案結構不被改壞。
- 檢查,然後匯入。看一遍結果,再把一條或兩條完成的字幕匯入 CinemaCC。
再放進 CinemaCC 播放
CinemaCC 負責播放完成的字幕,這個 Skill 只處理匯入前的檔案準備。
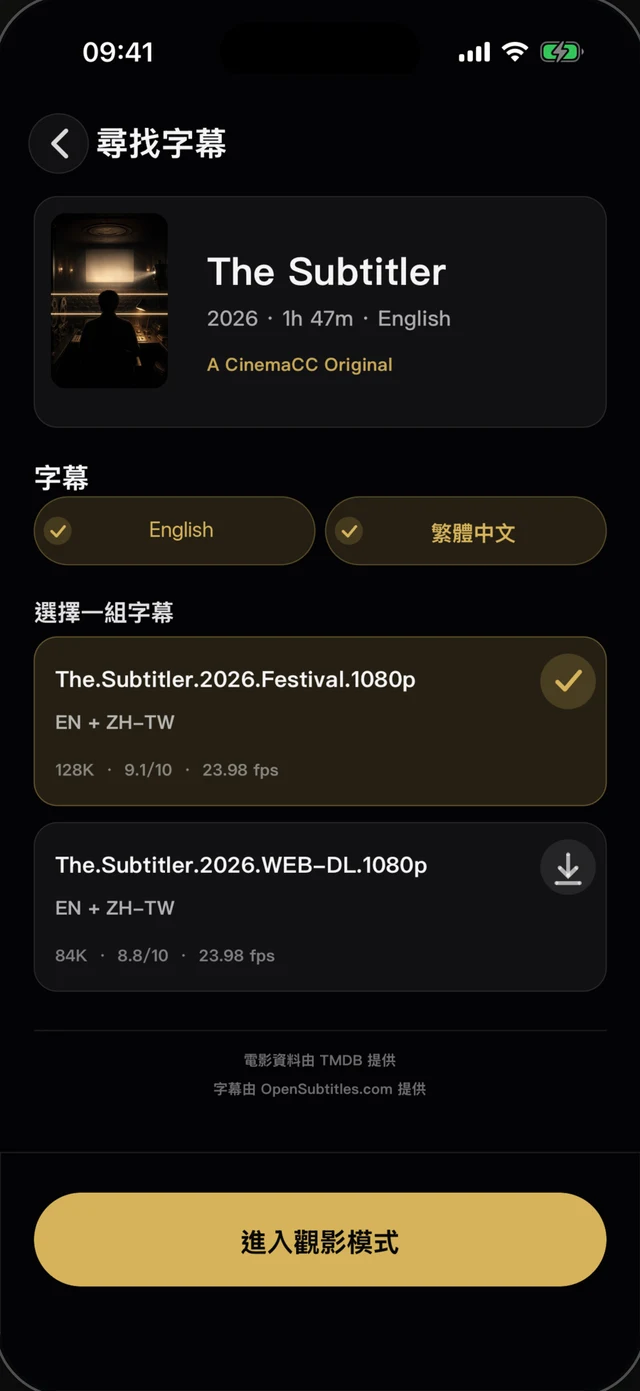
1 · 帶上你自己的 SRT 檔
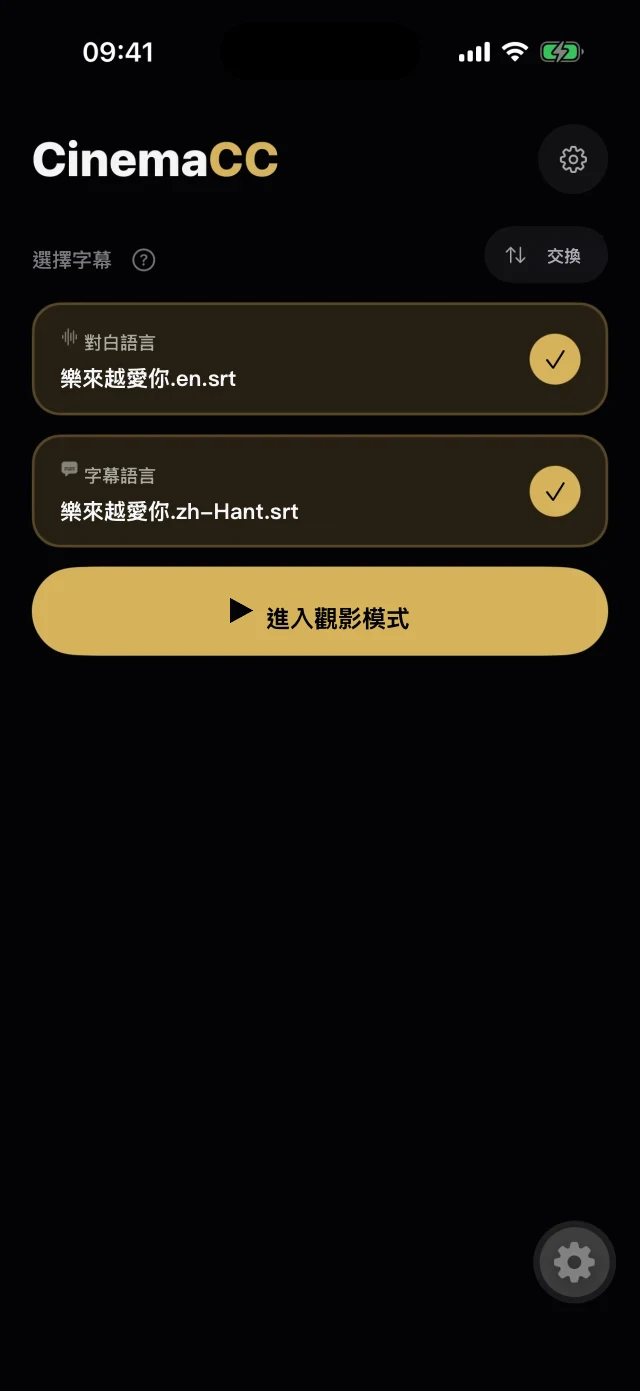
2 · 一條或兩條字幕,準備就緒
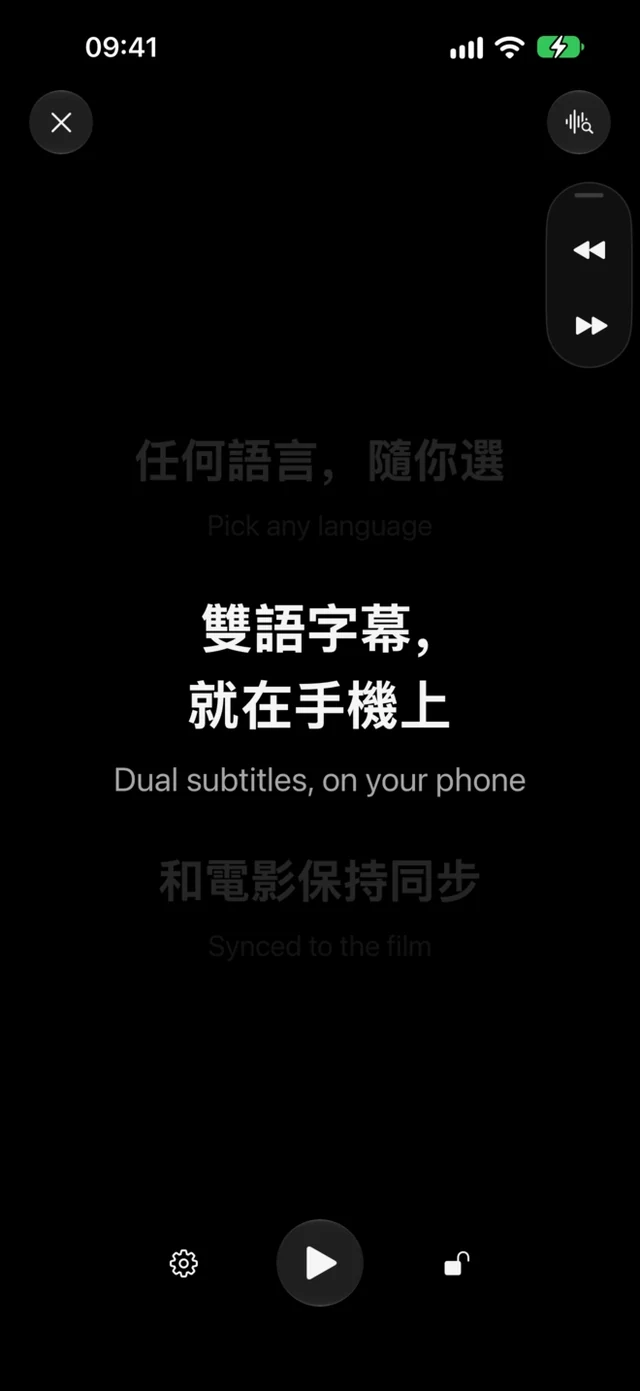
3 · 在黑暗中跟著看
每個分段都參照同一份背景資料
這兩個錯誤都需要語境才能發現,所以我們把翻譯前的背景調查和檢查,整理成了一套可以重複使用的流程:CinemaCC Subtitle Skill。Agent 先查電影背景,把角色身分、關係、地點和反覆出現的術語寫進背景資料和術語表,也記下依據和不確定的地方,不假設模型已經知道每一部電影、每一種改編。
長字幕分段處理時,每一段都參照同一份資料。前面選定的名字和劇情含義,後面還有依據可查,不用每翻一段就重新猜一次。
台詞和檔案,分開檢查
Agent 負責讀懂台詞
Agent 處理台詞和語境:先檢查來源字幕,有問題就先修復再翻譯,無法確定的讀法留下來複查。簡體中文和繁體中文分開審閱,不只做字元轉換。
腳本負責檢查檔案
Python 腳本檢查字幕編號、時間碼、格式標籤和檔案結構。腳本能發現 SRT 被改壞,卻不能判斷某一句裡的 Hades 到底是神還是地點。除非你明確允許,並提供匹配的視聽證據,否則 Skill 不會改字幕編號和時間軸。
使用前需要知道的事
- 程式碼:使用 MIT 授權條款,免費開源。
- Agent 自備:CinemaCC 不提供模型或翻譯服務。你選擇的 Agent 或模型服務商可能收費,也有各自的隱私條款。
- 不含字幕:儲存庫裡沒有商業電影或影集字幕。
- 版權自己確認:輸入和輸出字幕能否使用、翻譯或散布,需要你自己確認。
連結
這裡整理了原始碼、安裝和發布頁面。